


- Modelo
- Urdu · inglés
- CC BY-NC 4.0
Urdu Sukhan ASR
Un modelo de reconocimiento de voz en urdu que también entiende inglés y el habla que pasa del urdu al inglés. Está ajustado desde Whisper large-v3-turbo de OpenAI y comete un 39 % menos de errores de palabra que ese modelo en siete conjuntos de prueba de urdu reservados. Conserva la velocidad y el tamaño del modelo turbo, más o menos la mitad que Whisper large-v3.
Mejor urdu
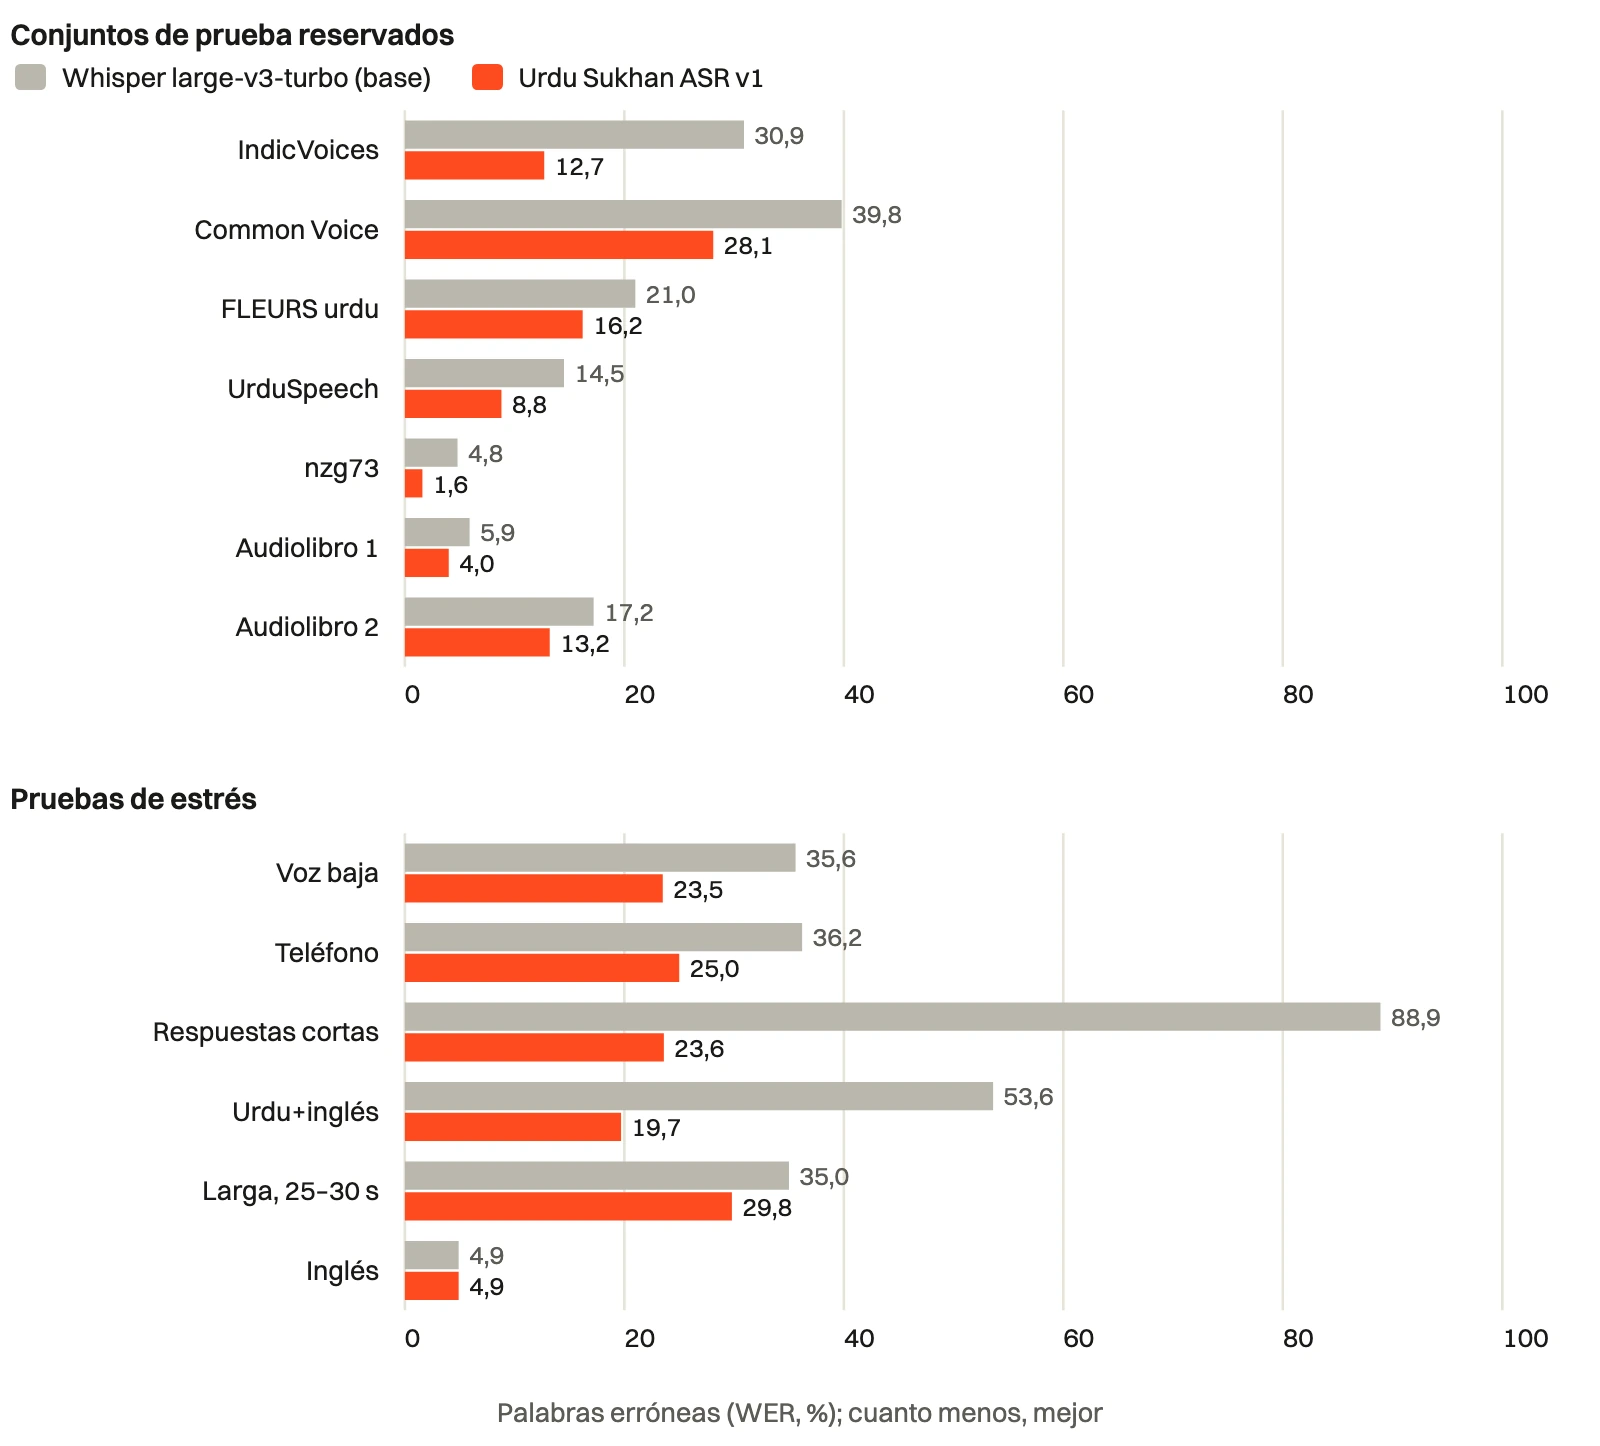
Del 30,9 % al 12,7 % de palabras erróneas en IndicVoices, del 39,8 % al 28,1 % con hablantes de Common Voice que nunca oyó, y mejor en todas nuestras pruebas de urdu.
Inglés y habla mixta
El inglés se mantiene tan preciso como en el modelo base. Los clips que pasan del urdu al inglés bajan del 53,6 % al 19,7 % de palabras erróneas, con las palabras inglesas en letras latinas.
Respuestas cortas y silencio
Las respuestas de una o dos palabras bajan del 88,9 % al 23,6 % de palabras erróneas. Sin la supresión de la respuesta vacía, no escribe nada sobre silencio, ruido o música.
Tres formatos
Transformers (fp16) para Python y GPU, whisper.cpp (q8_0, q5_0, q4_0) para CPU y Apple Silicon, y CTranslate2 int8 para faster-whisper.
La mitad que large-v3
809 millones de parámetros, frente a 1550 millones de Whisper large-v3, con 32 capas de codificador y 4 de decodificador. Una ventana de 30 segundos tarda 1,3 segundos en la GPU de un Apple M4.
Método abierto
Las fuentes de datos, cada ronda de entrenamiento, también las que fallaron, y cada evaluación están publicadas en nuestro informe de investigación y en GitHub.
Resultados
Palabras erróneas (WER, %) con la misma normalización para los dos modelos y decodificación voraz en Hugging Face Transformers. Ninguno de estos conjuntos se usó para entrenar.
| Conjunto | Whisper large-v3-turbo | Urdu Sukhan ASR v1 |
|---|---|---|
| IndicVoices urdu, validación | 30,9 | 12,7 |
| Common Voice, hablantes no vistos | 39,8 | 28,1 |
| FLEURS urdu, prueba | 21,0 | 16,2 |
| UrduSpeech, partición de prueba | 14,5 | 8,8 |
| nzg73, clips reservados | 4,8 | 1,6 |
| Audiolibro 1, capítulos reservados | 5,9 | 4,0 |
| Audiolibro 2, capítulo reservado | 17,2 | 13,2 |
| Estrés: respuestas de una o dos palabras | 88,9 | 23,6 |
| Estrés: urdu y luego inglés en un clip | 53,6 | 19,7 |
| Estrés: inglés (FLEURS) | 4,9 | 4,9 |
Los conjuntos de prueba que podemos compartir, 808 clips (unos 96 minutos) de las pruebas de Common Voice y FLEURS en urdu y de ocho pruebas de estrés, están en Hugging Face bajo solicitud. IndicVoices, UrduSpeech y nzg73 se obtienen de sus editores.
Frente a Whisper large-v3
Urdu Sukhan ASR tiene la estructura de Whisper large-v3-turbo: el mismo codificador de 32 capas que Whisper large-v3 y un decodificador de 4 capas en lugar de 32.
| Whisper large-v3 | Urdu Sukhan ASR (estructura turbo) | |
|---|---|---|
| Parámetros | 1550 M | 809 M |
| Capas de codificador / decodificador | 32 / 32 | 32 / 4 |
| Archivo de whisper.cpp, fp16 | 3095 MB | 1625 MB |
| Archivo de whisper.cpp, q5_0 | 1081 MB | 574 MB |
| Memoria de GPU (OpenAI) | unos 10 GB | unos 6 GB |
| Velocidad relativa (OpenAI: inglés, A100) | 1× | unas 8× |
La cifra de velocidad de OpenAI se debe al decodificador más pequeño. En una CPU con whisper.cpp, el codificador, del mismo tamaño en los dos modelos, hace alrededor del 95 % del trabajo, así que allí la ganancia es mucho menor. No hemos medido ni puntuado Whisper large-v3 nosotros mismos.
Fuentes:
Cómo usarlo
Pruébalo en Colab, sin instalar nada
Nuestro cuaderno de Colab ejecuta el modelo en tu propia sesión de Google Colab, con una GPU gratuita o con la CPU: graba con el micrófono, sube un archivo o prueba los clips de ejemplo, con los ajustes recomendados ya incluidos. Necesita una solicitud de acceso aprobada y una cuenta gratuita de Google. Tu audio va a tu sesión de Colab en los servidores de Google, nunca a Loudness.ai.
whisper.cpp (línea de comandos)
git clone https://github.com/Loudness-ai/urdu-sukhan-asr.git
cd urdu-sukhan-asr
bash examples/whisper_cpp.sh voz.wav
faster-whisper (Python)
python -m pip install faster-whisper==1.2.1 ctranslate2==4.8.3 huggingface_hub==2.2.0 soundfile==0.14.0 soxr==1.1.0
python examples/transcribe_faster_whisper.py voz.wav
Transformers (Python)
python -m pip install -r examples/requirements.txt
python examples/transcribe_transformers.py voz.wav
Los archivos del modelo se comparten bajo solicitud, así que primero pide acceso en Hugging Face e inicia sesión con hf auth login. Después, cada comando ejecuta un script probado de la carpeta examples del repositorio en GitHub. La guía de instalación explica cada formato paso a paso, con los ajustes y los problemas más comunes:
Ajustes recomendados
- Fija el idioma (
uroen) cuando lo sepas. La detección automática ejecuta el codificador una vez más en whisper.cpp. - Desactiva la supresión de la respuesta vacía para que el silencio no devuelva nada: la opción
-nsbdel whisper-cli con el parche que compila nuestro script, osuppress_blank = falseen la biblioteca whisper.cpp. - Decodifica con haz de 5, sin marcas de tiempo y sin arrastrar contexto.
- Pasa antes un detector de actividad de voz y corta los archivos largos en las pausas en trozos de unos 25 segundos como máximo. El detector puede descartar voz débil, como el inglés bajo después del urdu, así que desactívalo si faltan palabras (
VAD=0o--no-vaden nuestros scripts). - En whisper.cpp, q8_0 es el mejor formato en Apple Silicon y q4_0 el más rápido en servidores x86.
- En una CPU, usa whisper.cpp o faster-whisper: Transformers va allí unas diez veces más lento que el tiempo real.
Limitaciones
Léelas antes de confiar en el modelo.
- Los nombres son su punto más débil. El capítulo de prueba de nuestro segundo audiolibro tiene 23 apariciones de nombres: Urdu Sukhan ASR escribió bien 11 y el modelo base 4. Los nombres que casi no oyó al entrenar salen como palabras comunes parecidas; por ejemplo, عمیر (Umair) como امیر («rico») y تانیا (Tania) como دانیا. Una indicación con los nombres esperados subió la cuenta de 12 a 17 de 23 en whisper.cpp. Las noticias de FLEURS, llenas de nombres extranjeros, son donde menos mejora. Cuando los nombres importen (personas, lugares, marcas), dáselos en una indicación y revísalos a mano.
- Separación de palabras y grafía. A veces une o separa palabras (آنندوہار por آنند وہار), y la grafía sigue nuestro estilo de la casa, que puede diferir del tuyo.
- Sin puntuación. Las transcripciones salen sin puntuación, como el texto de entrenamiento.
- El inglés muy débil después del urdu puede salir en letras urdu o repetir una palabra.
- Pronunciaciones propias de un narrador, por ejemplo una ھ que no se pronuncia (پھر oído como پر), a veces se escriben tal como suenan.
- Silencio. Sin el ajuste de respuesta vacía de arriba, escribe una palabra como اچھا sobre el silencio, como todo modelo Whisper.
- Acentos y situaciones. IndicVoices es sobre todo urdu de la India, la prueba de Common Voice tiene pocas mujeres y no tenemos ninguna prueba de conversaciones telefónicas espontáneas entre hablantes de Pakistán. Nuestros conjuntos de prueba son pequeños (de 20 a 300 clips) y no damos intervalos de confianza.
- Velocidad en CPU. Cada clip paga una ventana completa de 30 segundos, así que los clips cortos en directo van más lentos que el tiempo real en CPU pequeñas.
- Sin medir. No hemos puntuado ni medido Whisper large-v3, ni el uso de memoria, ni hemos ejecutado el modelo en un teléfono.
Próxima versión
Lo que pensamos cambiar en el próximo modelo, cada punto a partir de un problema que mostró este:
| Problema en v1 | Plan para el próximo modelo |
|---|---|
| Nombres: 11 de 23 bien en nuestro capítulo de prueba; los nombres raros se convierten en palabras comunes | Más voz de entrenamiento rica en nombres (noticias, entrevistas, historias con muchos personajes), un conjunto de prueba de nombres más grande e indicaciones con nombres en los ejemplos y en la página de pruebas |
| La voz débil del entrenamiento enseñó al modelo a oír palabras en el siseo | Llevar cada clip a un nivel normal antes de aumentarlo |
| Una palabra sobre el silencio salvo que se permita la respuesta vacía | Codificar las transcripciones vacías sin espacio, para que el modelo pueda parar con los ajustes por defecto |
| El ruido y la música de las pruebas de estrés se oyeron al entrenar | Dejar el ruido y la música de las pruebas fuera del aumento de datos |
| Palabras unidas o separadas | Revisar la separación de palabras en las transcripciones de entrenamiento y contar esos errores aparte |
| Cada clip paga una ventana de 30 segundos en CPU | Ajustar para ventanas de audio más cortas; entrenar un alumno más pequeño y rápido con más audio transcrito por el maestro (nuestro alumno de 16 capas era 1,9 veces más rápido en el codificador, pero entre 0,5 y 5,4 puntos menos preciso, así que no se publica) |
| Sin versión para iPhone (el codificador de Core ML perdía precisión) | Una versión precisa para iPhone que funcione en el dispositivo |
| Situaciones que no hemos probado | Habla conversacional y telefónica de Pakistán, más hablantes mujeres, conjuntos de prueba más grandes con intervalos de confianza, mediciones de memoria y en teléfono, y una comparación directa con Whisper large-v3 |
Datos y créditos
Entrenado con unas 110 horas: IndicVoices y la parte urdu de Rasa, de AI4Bharat, Mozilla Common Voice, Google FLEURS, el conjunto de Muhammad Noman – nzg73 con su propia licencia, solo el audio de UAT (transcrito por nuestro propio modelo; sin licencia pública; usado con el acuerdo de sus desarrolladores), ruido y música de MUSAN, y dos audiolibros leídos por dos narradores, con transcripciones revisadas por Asad Shehzad. El informe de investigación recoge cada fuente y sus condiciones.
Informe de investigación Audio de ejemplo en Hugging FaceConjuntos de prueba en Hugging Face
Funciona donde tú lo ejecutes
El modelo funciona en tu ordenador, tu servidor o tu aplicación, y el audio nunca se envía a Loudness.ai. Para descargarlo necesitas una cuenta de Hugging Face con acceso aprobado; para ejecutarlo no hace falta cuenta ni clave.
Licencia
Urdu Sukhan ASR se publica con la licencia CC BY-NC 4.0: gratis para uso no comercial, citando la fuente. Los archivos del modelo se comparten bajo solicitud: pide acceso en Hugging Face y aprobamos cada solicitud a mano. Para uso comercial, contacta con nosotros.
¿Prefieres el navegador?
Limpia una grabación antes de transcribirla, gratis y en línea:
Mejorador de audioEliminador de ecoExtraer audio de un vídeoEliminador de silencios
Cómo citarlo
Shehzad, A. (2026). Urdu Sukhan ASR: Accurate Urdu Speech Recognition at Half the Size of Whisper large-v3. Informe técnico LA-RB-2026-004, Loudness.ai. DOI: 10.5281/zenodo.23518703.
Los archivos BibTeX y RIS están en la página del informe de investigación:
Enlaces
Hugging FaceGitHubAudio de ejemplo en Hugging FaceConjuntos de prueba en Hugging Face Pruébalo en Colab
 Guía de instalaciónInforme de investigaciónAI Noise Remover SDKloudness-ttsTodas las guías para desarrolladores