


Urdu Sukhan ASR: reconocimiento de voz preciso en urdu con la mitad del tamaño de Whisper large-v3
Nuevo modelo de voz a texto en urdu con la mitad del tamaño de Whisper large-v3 y un 39 % menos de errores que Whisper large-v3-turbo en siete pruebas.
Resumen
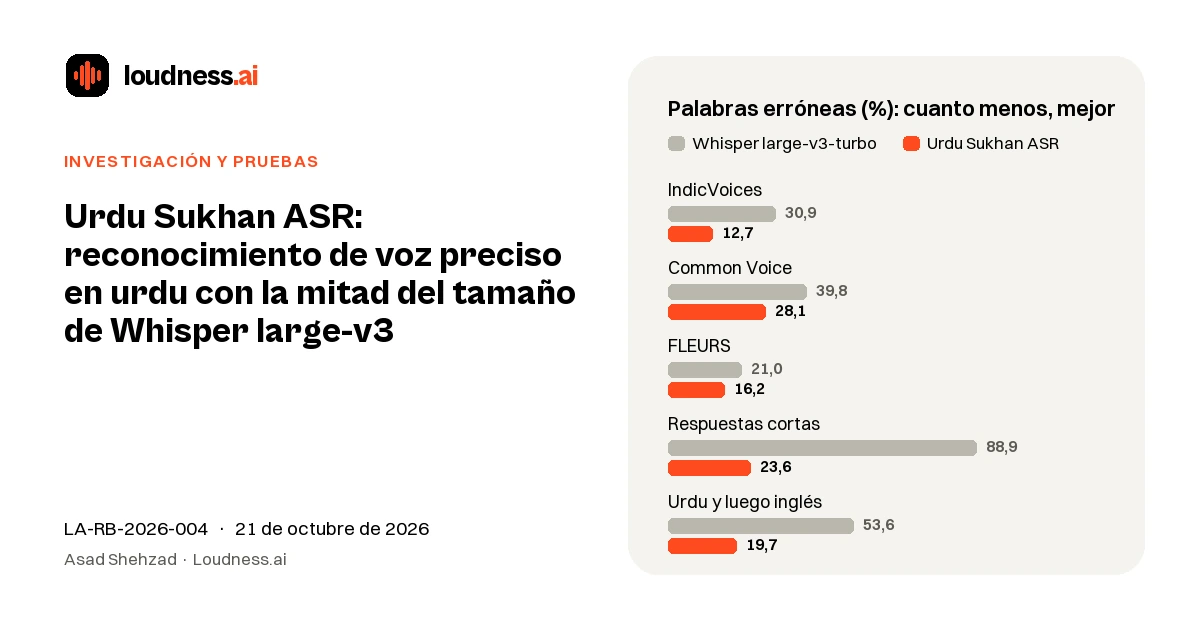
Describimos Urdu Sukhan ASR v1, un modelo de reconocimiento de voz en urdu que también entiende inglés y la mezcla de urdu e inglés, y cómo se entrenó y se probó, incluidas las rondas que fallaron. Conserva el tamaño de Whisper large-v3-turbo, más o menos la mitad que Whisper large-v3. Frente al modelo base turbo con la misma decodificación, comete de media un 39 % menos de errores de palabra en siete conjuntos de prueba de urdu reservados: del 30,9 % al 12,7 % en IndicVoices, del 39,8 % al 28,1 % con hablantes de Common Voice no vistos en el entrenamiento y del 21,0 % al 16,2 % en FLEURS. En respuestas de una o dos palabras el error baja del 88,9 % al 23,6 % y en clips que pasan del urdu al inglés del 53,6 % al 19,7 %, mientras que el inglés se mantiene en el 4,9 %. También mostramos por qué los modelos Whisper escriben una palabra sobre el silencio y cómo lo evita un solo ajuste, y damos la velocidad en cuatro máquinas.
Qué construimos
Urdu Sukhan ASR v1 es un modelo de reconocimiento de voz en urdu que también entiende inglés y la mezcla de urdu e inglés en una misma frase. Es un ajuste completo de Whisper large-v3-turbo de OpenAI, así que conserva el tamaño y la velocidad del modelo turbo: 809 millones de parámetros, más o menos la mitad de los 1550 millones de Whisper large-v3. Se entrenó con unas 110 horas de audio transcrito por pasada: corpus públicos de urdu, dos audiolibros leídos por dos narradores con transcripciones revisadas por el autor, clips de urdu e inglés que montamos y audio sin voz.
Frente al modelo base con la misma decodificación, comete menos errores de palabra en los siete conjuntos de prueba de urdu reservados, un 39 % menos de media. Este informe describe los datos, las seis rondas de entrenamiento (dos fallaron con audio bajo), cómo se eligió el punto de control publicado, por qué los modelos Whisper escriben una palabra sobre el silencio, la velocidad en cuatro máquinas con tres motores y un experimento de compresión que no fue lo bastante bueno para publicarlo. El artículo completo, con todas las tablas, es el PDF del final de esta página.
Frente al modelo base
Palabras erróneas (tasa de error de palabras, WER) del modelo base y del nuestro, ambos con decodificación voraz en Hugging Face Transformers y la misma normalización del texto. Ninguno de estos conjuntos se usó para entrenar. Las mayores mejoras están en el habla conversacional de muchos hablantes (IndicVoices, un 59 % menos de errores), en el único hablante de nzg73 (67 %), en las respuestas de una o dos palabras (73 %) y en los clips que pasan del urdu al inglés (63 %). FLEURS, texto leído de Wikipedia con muchos nombres y palabras técnicas, es el conjunto público que menos mejora (23 %), y el inglés se mantiene en el 4,9 %.
| Conjunto | Clips | Whisper large-v3-turbo | Urdu Sukhan ASR v1 |
|---|---|---|---|
| IndicVoices urdu, validación | 300 | 30,9 | 12,7 |
| Common Voice, hablantes no vistos | 260 | 39,8 | 28,1 |
| FLEURS urdu, prueba | 299 | 21,0 | 16,2 |
| UrduSpeech, partición de prueba | 100 | 14,5 | 8,8 |
| nzg73, clips reservados | 300 | 4,8 | 1,6 |
| Audiolibro 1, capítulos reservados | 48 | 5,9 | 4,0 |
| Audiolibro 2, capítulo reservado | 10 | 17,2 | 13,2 |
| Estrés: voz baja (30 dB menos) | 40 | 35,6 | 23,5 |
| Estrés: voz por línea telefónica | 40 | 36,2 | 25,0 |
| Estrés: respuestas de una o dos palabras | 40 | 88,9 | 23,6 |
| Estrés: urdu y luego inglés en un clip | 20 | 53,6 | 19,7 |
| Estrés: voz continua, 25–30 s | 15 | 35,0 | 29,8 |
| Estrés: inglés (FLEURS) | 30 | 4,9 | 4,9 |

Ejemplos
Las tasas de error no muestran cómo son los errores. Pasamos 47 clips de prueba públicos con voz, y dos sin voz, por los dos modelos como lo haría una aplicación (whisper.cpp, q8_0, haz de 5, reintento con temperatura). En estos clips, nuestro modelo fue mejor en 27, peor en 4 e igual en 16 (19,1 % frente a 37,8 % de palabras erróneas).
La tabla muestra clips cortos que elegimos a mano para enseñar dónde más ayuda el ajuste, de lo alto de una clasificación de todos los clips por palabras corregidas, y uno de los 4 clips en los que salió peor; la  ficha del modelo en Hugging Face (en inglés) los tiene con su audio. El modelo base convierte las respuestas cortas en otras palabras, incluso en «música» por un «hola» hablado y en «Alá, Alá» por «por separado». Las mayores mejoras fueron en clips que pasan del urdu al inglés, demasiado largos para la tabla: en uno, el modelo base escribió cuatro palabras en inglés para un clip de 28 palabras; en otro, tradujo al inglés la mitad en urdu en lugar de transcribirla. El nuestro transcribió los dos, con dos palabras erróneas en total. Aún falla en la separación de algunas palabras, como muestra el último ejemplo. Sobre el silencio, permitir un resultado vacío solo ayuda a nuestro modelo: el modelo base sigue escribiendo una palabra.
| Clip y significado | Sistema | Transcripción | Resultado |
|---|---|---|---|
| Respuesta de dos palabras, IndicVoices «por separado» | Referencia | الگ الگ | 2 palabras |
| large-v3-turbo | اللہ اللہ | 2 errores | |
| Urdu Sukhan | الگ الگ | ningún error | |
| Respuesta de una palabra, IndicVoices «hola» | Referencia | ہیلو | 1 palabra |
| large-v3-turbo | موسیقی | 1 error | |
| Urdu Sukhan | ہیلو | ningún error | |
| IndicVoices «sí, sí, sí, sí» | Referencia | جی جی جی ہاں | 4 palabras |
| large-v3-turbo | دی دی دی ہاں | 3 errores | |
| Urdu Sukhan | جی جی جی ہاں | ningún error | |
| Voz baja «Tom sobrevivió al accidente de coche.» | Referencia | ٹام کار کے حادثے میں بچ گیا تھا | 8 palabras |
| large-v3-turbo | ٹوم کار کی ہاتھ سے میں بچ کیا تھا | 5 errores | |
| Urdu Sukhan | ٹوم کار کے حادثے میں بچ گیا تھا | 1 error | |
| Línea telefónica «la libertad que se ve en este ambiente» | Referencia | اس ماحول میں جو آزادی نظر آتی ہے | 8 palabras |
| large-v3-turbo | اس محول میں جو ازادی نظر آتی ہے | 2 errores | |
| Urdu Sukhan | اس ماحول میں جو آزادی نظر آتی ہے | ningún error | |
| UrduSpeech, el nuestro peor «Gaya–Anand Vihar Garib Rath Express (un tren)» | Referencia | گیا آنند وہار غریب رتھ ایکسپریس | 6 palabras |
| large-v3-turbo | گیا آنند ویہار غریب رتھ ایکسپریس | 1 error | |
| Urdu Sukhan | گیا آنندوہار [–] غریب رتھ ایکسپریس | 2 errores | |
| Siseo débil, sin voz | large-v3-turbo | موسیقی | 1 error |
| Urdu Sukhan | اچھا | 1 error | |
| Urdu Sukhan, respuesta vacía permitida | (nada) | ningún error |
Los clips y sus transcripciones de referencia vienen de conjuntos de prueba públicos: IndicVoices y UrduSpeech (AI4Bharat, CC BY 4.0), Common Voice (Mozilla, CC0) y FLEURS (Google, CC BY 4.0). Los clips de voz baja, de línea telefónica y de urdu seguido de inglés son clips de Common Voice y FLEURS que bajamos de volumen, pasamos por un filtro telefónico o unimos. El siseo es generado, y ningún ejemplo viene de los dos audiolibros.
Datos de entrenamiento
El modelo publicado se entrenó con 59.165 clips en una sola pasada (unas 110 horas), muestreados de 87.571 clips depurados (unas 151 horas). Todas las fuentes, salvo los dos audiolibros, son públicas.
El conjunto UAT no tiene licencia pública y sus transcripciones las hizo una máquina, así que solo usamos su audio, transcrito por nuestro propio modelo, con el acuerdo de sus desarrolladores. El conjunto nzg73 de Muhammad Noman se usa con su propia licencia, que permite entrenar modelos de voz citando a su autor y prohíbe usos indebidos como las suplantaciones (deepfakes). Revisamos y descartamos otros cuatro conjuntos: uno de texto a voz con licencia no comercial, un corpus sintético de texto a voz, una colección de pódcasts sin licencia y un corpus de emociones sin transcripciones.
Antes de la última ronda se eliminó todo clip de menos de 0,5 o más de 30 segundos, sin texto, con más letras por segundo de las que cabe pronunciar (o demasiado pocas para su duración), o en urdu con menos de un 60 % del texto en escritura urdu. La última ronda añadió además 2800 clips sin voz con la transcripción vacía (ruido, música instrumental, silencio digital, siseo de micrófono y zumbido de la red) y 782 clips que unen un clip en urdu y otro en inglés, con la parte inglesa escrita en letras latinas.
| Fuente | Condiciones | Clips por pasada |
|---|---|---|
| IndicVoices urdu (AI4Bharat) | CC BY 4.0 | 20.000 |
| Common Voice urdu (Mozilla; reempaquetado de Kaggle) | CC0 | 12.000 |
| UAT, solo audio, transcrito por nuestro propio modelo | Sin licencia pública; usado con el acuerdo de sus desarrolladores | 10.000 |
| UrduSpeech (parte urdu de Rasa, de AI4Bharat) | CC BY 4.0 | 4999 |
| nzg73 Urdu_Audio-Realistic, crédito: Muhammad Noman – nzg73 | Su propia licencia; exige citar al autor | 3000 |
| FLEURS urdu, entrenamiento y validación; inglés, entrenamiento (Google) | CC BY 4.0 | 2370; 2000 |
| Dos audiolibros leídos por dos narradores; transcripciones revisadas por el autor | No se redistribuyen | 1214 (521 clips repetidos 2 o 4 veces) |
| Clips urdu–inglés unidos a partir de FLEURS y Common Voice | Las de sus fuentes | 782 |
| Sin voz: ruido y música de MUSAN, siseo y zumbido generados | CC BY 4.0 | 2800 |
Los audiolibros y el ciclo de revisión
Se usaron dos audiolibros, cada uno leído por un narrador distinto: una traducción al urdu de un libro de autoayuda (3,97 horas) y una novela en urdu (unas 1,2 horas). Se cortaron en las pausas en clips de 25 segundos como máximo y el modelo base hizo un primer borrador. El autor corrigió los borradores en una herramienta web hecha para ello, que marca las palabras dudosas, reproduce cualquier palabra con un clic y muestra la tasa de error de los borradores en los clips ya terminados. Cada cinco clips terminados, las correcciones se convertían en reglas para los borradores restantes: 765 reglas al final, cada una comprobada en todos los borradores a los que afectaba.
El modelo de cada ronda volvía a redactar los clips pendientes. En el primer libro, el autor cambió el 6,1 % de las palabras de los borradores del modelo base y el 3,4 % de los de la ronda 1. En total se revisaron 579 clips (2,85 horas): 521 para entrenar y 58 reservados para las pruebas. La regla final fue «transcribir lo que dice el hablante»: se corrigen la ortografía, los nombres y el estilo de la casa, pero nunca se «mejora» lo que dice el hablante, para que el modelo no aprenda a corregir a nadie.
El urdu admite varias grafías para palabras frecuentes, y entrenar con todas enseña a un modelo a ser incoherente. Aplicamos un único estilo de la casa a cada frase de entrenamiento y de prueba, y a los dos lados antes de puntuar: por ejemplo لیے (liye) en lugar de لئے, y los verbos compuestos escritos en dos palabras. Solo esto bajó el error del modelo base en FLEURS del 22,5 % al 21,0 %: la variación ortográfica valía alrededor de 1,5 puntos.
Seis rondas de entrenamiento
Las rondas 1 a 3 se hicieron en el portátil (Apple M4, 16 GB) con LoRA solo en el decodificador y enseñaron al modelo las dos voces de los audiolibros. Las rondas 4 a 6 usaron una RTX A4000 alquilada (16 GB). La ronda 4 entrenó LoRA en el codificador y el decodificador con aumento de audio, y la ronda 5 fue el primer ajuste completo de los 809 millones de pesos. La ronda 6, el modelo publicado, añadió IndicVoices, UrduSpeech, inglés, los clips de mezcla de idiomas y sin voz y ruido de fondo, usó la mitad de la tasa de aprendizaje de la ronda 5 y completó una sola pasada en 4,5 horas de GPU.
La ronda 5 fue el modelo más preciso hasta entonces con habla leída, pero escribió repeticiones descontroladas en 21 de 260 clips de Common Voice de hablantes no vistos e inventó texto en 30 de 30 clips de silencio. Una media al 50 % de los pesos de las rondas 4 y 5 fue nuestro mejor modelo hasta la ronda 6, pero inventó texto en 35 de 100 clips sin voz. La ronda 6 entrenó con cinco veces más datos, con clips sin voz y de mezcla de idiomas, y es la primera que escribe las palabras inglesas en letras latinas.
| Ronda | Método | Datos por pasada | Pasos × lote | Tasa de aprendizaje | Tiempo |
|---|---|---|---|---|---|
| R1 | LoRA, decodificador (portátil) | 218 clips de libro ×4, 600 de FLEURS | 368 × 8 | 2e-4 | 40 min |
| R2 | LoRA, decodificador (portátil) | 365 clips de libro ×3, 600 de FLEURS | 422 × 8 | 2e-4 | 73 min |
| R3 | LoRA, decodificador, marcas de tiempo (portátil) | 520 clips de libro (×2, ×5), 600 de FLEURS | 472 × 8 | 2e-4 | 67 min |
| R4 | LoRA, codificador y decodificador | Libros, nzg73, FLEURS; 6409 clips | 800 × 16 | 1e-4 | 99 min |
| R5 | Ajuste completo | Datos de R4, Common Voice, UAT; 17.409 clips | 2176 × 16 | 1e-5 | 164 min |
| R6 (released) | Ajuste completo | Todas las fuentes anteriores; 59.165 clips | 3697 × 16 | 5e-6 | 268 min |
Elegir el punto de control
La precisión con voz mejoró hasta el paso 2775 de 3697. En los últimos 922 pasos, mientras la tasa de aprendizaje bajaba a cero, el modelo aprendió a oír palabras en el audio débil: el texto inventado sobre el silencio subió de 3 a 27 de 30 clips y sobre el ruido de 6 a 21 de 40, y la voz baja pasó del 23,5 % al 271,6 % de palabras erróneas. Publicamos el paso 2775. Las medias de pesos de ese paso con el último, y con la media de las rondas 4 y 5, ganaron hasta 2,5 puntos en el segundo audiolibro y perdieron en el resto, así que no se conservó ninguna.

Texto inventado sobre el silencio
La ronda 5 y el final de la ronda 6 aprendieron que un siseo débil significa voz. Medir el nivel del audio de entrenamiento explica por qué. Las grabaciones de FLEURS en urdu son muy bajas: mediana de −45 dBFS, con uno de cada veinte clips por debajo de −60 dBFS, lo que se solapa con el siseo de nuestra prueba de silencio (−66 a −52 dBFS). Dos ajustes del aumento de datos añadieron más: uno «muy bajo» que redujo una quinta parte de los clips aumentados entre 12 y 30 dB, y un filtro de eco de sala que bajaba los clips con eco otros 20 a 25 dB. Juntos dejaron voz con transcripción completa por debajo del siseo de la prueba de silencio, así que un modelo premiado por transcribirla aprende a transcribir el siseo.
La solución es llevar primero cada clip a un nivel normal, aplicar el nivel final después del filtro de eco, no bajar nunca de −40 dBFS y mantener el ruido entre 15 y 35 dB por debajo de la voz baja.

La respuesta de una palabra es una regla de decodificación
Por defecto, whisper.cpp (suppress_blank) y Transformers (begin_suppress_tokens) prohíben el símbolo de fin de texto y un espacio como primer símbolo generado, así que un modelo Whisper no puede devolver una transcripción vacía. Con clips sin voz, nuestro modelo pone casi toda su probabilidad justo en esos símbolos prohibidos, de modo que por defecto tiene que escribir una palabra, normalmente اچھا (achha), «de acuerdo», o ہاں (haan), «sí». La medida habitual de dos palabras lo oculta: por defecto, tanto el modelo base como el nuestro escriben al menos una palabra en cada clip de ruido, música y silencio.
Con esa supresión desactivada (una línea en una aplicación: params.suppress_blank = false), nuestro modelo no escribe nada en los 100 clips sin voz y ninguna puntuación con voz cambia. Pasar antes un detector de voz también elimina casi todo el texto inventado, pero en nuestras pruebas descartó como silencio voz inglesa débil.

Nombres y palabras inglesas
Los nombres son el punto más débil. El capítulo de prueba del segundo audiolibro tiene 23 apariciones de nombres; el modelo base escribió bien 4 y el nuestro 11 con decodificación voraz. Una indicación de whisper.cpp con la lista de nombres del capítulo subió la cuenta de 12 a 17 de 23. El inglés dentro del habla en urdu se mantiene en letras latinas, como prefiere el autor para leer. Esto difiere de las transcripciones de los audiolibros, que escriben los préstamos ingleses en escritura urdu; los dos criterios aún no se han unificado.
Velocidad y despliegue
El modelo publicado tiene exactamente la estructura de Whisper large-v3-turbo, así que su velocidad es la del modelo base. En whisper.cpp el codificador domina el tiempo de CPU: siempre procesa una ventana completa de 30 segundos, así que una respuesta de un segundo cuesta tanto tiempo de codificador como 30 segundos de voz. Una ventana tarda 1,3 s en la GPU del portátil, 5,4 s en su CPU y 11,2 s en un servidor en la nube de 12 núcleos.
En ese servidor, la detección automática del idioma ejecutó el codificador dos veces, q4_0 fue el formato de whisper.cpp más rápido y q5_0 el más lento, y los 12 hilos fueron más lentos que 8 mientras funcionaban otros servicios. faster-whisper transcribió una grabación de 27,4 minutos en 15,6 minutos con decodificación voraz (1,76 veces el tiempo real). Los archivos de whisper.cpp ocupan 874 MB (q8_0), 574 MB (q5_0) y 474 MB (q4_0).
Ajustes recomendados: fija el idioma cuando lo sepas, o detéctalo una vez por conversación o archivo; desactiva la supresión de la respuesta vacía; pasa antes un detector de voz salvo cuando importe la voz débil; decodifica sin marcas de tiempo y sin arrastrar contexto; en servidores x86 usa q4_0 y unos ocho hilos por trabajo.

Un experimento de compresión
Para que el modelo fuera más rápido en CPU destilamos un alumno con 16 de las 32 capas del codificador y las 4 del decodificador. Tras unas 11 horas de GPU, el alumno conservado era 1,9 veces más rápido en el codificador en todas las máquinas e inventaba texto en 0, 1 y 0 clips de ruido, música y silencio, pero quedó entre 0,5 y 5,4 puntos por detrás en los conjuntos de prueba y era flojo en inglés, así que no se publica. Quitar la mitad de un codificador de 32 capas descarta más de lo que 110 horas de audio pueden recuperar: el camino es más audio transcrito por el modelo maestro, no más pasos.

Lecciones
El código de evaluación necesita tanto cuidado como el de entrenamiento. Un archivo de prueba con filas duplicadas, una regla de bucles que cambió tres veces, una regla de dos palabras que ocultaba las respuestas de una sola y dos trabajos de puntuación que borraban los resultados del otro cambiaron cifras que ya habíamos dado.
El nivel del audio forma parte de la etiqueta. Voz débil con transcripción completa enseñó a dos rondas a transcribir el siseo.
Los valores por defecto del decodificador forman parte del modelo. Las marcas de tiempo, la supresión de la respuesta vacía, la detección del idioma y el reintento con temperatura cambiaron los resultados más que algunas decisiones de entrenamiento.
Mide la velocidad en la máquina de destino. El procesador de 2012 del servidor de GPU era varias veces más lento que el servidor en la nube y daba una imagen equivocada, y la carga de otros servicios cambió qué número de hilos era el más rápido.
Limitaciones
Los conjuntos de prueba de los audiolibros son pequeños (58 clips) y proceden de los mismos dos narradores cuyos otros capítulos se usaron para entrenar; los de respuestas cortas y de mezcla tienen 40 y 20 clips. No damos intervalos de confianza. IndicVoices es sobre todo urdu de la India, las mujeres están infrarrepresentadas en la prueba de Common Voice y no tenemos ninguna prueba de conversaciones telefónicas espontáneas de hablantes de Pakistán. Las causas que damos para los fallos encajan con las mediciones, pero no se probaron una a una. No medimos el uso de memoria ni ejecutamos el modelo en un teléfono.
Modelo, código y datos
El modelo está en Hugging Face como Loudness-ai/urdu-sukhan-asr-v1 en formatos Transformers, whisper.cpp (q8_0, q5_0, q4_0) y CTranslate2 con la licencia CC BY-NC 4.0 para uso no comercial; el acceso se concede bajo solicitud y, para uso comercial, puedes contactar con nosotros. Los clips de ejemplo y su audio están en Loudness-ai/urdu-sukhan-asr-examples, y los conjuntos de prueba que podemos compartir (808 clips, unos 96 minutos, de las pruebas de Common Voice y FLEURS en urdu y de ocho pruebas de estrés) están en Loudness-ai/urdu-sukhan-asr-test-sets, también bajo solicitud. Cuando se apruebe tu solicitud, puedes probar el modelo en nuestro  cuaderno de Colab, que necesita una cuenta gratuita de Google y funciona en tu propia sesión de Colab. El código, la tabla de resultados de cada evaluación y los scripts que generan las tablas y figuras de este informe están en GitHub, en Loudness-ai/urdu-sukhan-asr. La instalación y los ajustes recomendados están en la página para desarrolladores de Urdu Sukhan ASR.
El punto de control original de precisión completa se perdió al apagar nuestro servidor de entrenamiento al final del trabajo; los pesos de Transformers se reconstruyeron a partir del archivo q8_0 y se comprobaron con los resultados de este informe. Las grabaciones de los audiolibros y el audio de UAT transcrito no se redistribuyen. Las pruebas de IndicVoices, UrduSpeech y nzg73 y los demás conjuntos públicos están disponibles en sus editores con sus propias condiciones. Este informe tiene licencia CC BY 4.0; el modelo y su código, CC BY-NC 4.0.
Conflictos de intereses y financiación
El autor desarrolla Loudness.ai, cuyos productos usarán el modelo descrito aquí. No se recibió financiación externa.
Referencias
Radford, A. et al. (2023). Robust speech recognition via large-scale weak supervision. ICML 2023.
Arif, S. et al. (2024). WER we stand: benchmarking Urdu ASR models. arXiv:2409.11252.
Koenecke, A. et al. (2024). Careless Whisper: speech-to-text hallucination harms. ACM FAccT 2024.
Conneau, A. et al. (2023). FLEURS: few-shot learning evaluation of universal representations of speech. IEEE SLT 2023. Ardila, R. et al. (2020). Common Voice: a massively-multilingual speech corpus. LREC 2020. Javed, T. et al. (2024). IndicVoices. Findings of ACL 2024. Snyder, D., Chen, G. and Povey, D. (2015). MUSAN: a music, speech, and noise corpus. arXiv:1510.08484.
Park, D. S. et al. (2019). SpecAugment. Interspeech 2019. Hu, E. J. et al. (2022). LoRA. ICLR 2022. Wortsman, M. et al. (2022). Model soups. ICML 2022. Hinton, G., Vinyals, O. and Dean, J. (2015). Distilling the knowledge in a neural network. arXiv:1503.02531. Gandhi, S., von Platen, P. and Rush, A. M. (2023). Distil-Whisper. arXiv:2311.00430.
Software: whisper.cpp 1.9.5, faster-whisper 1.2.1, Silero VAD y Chartist 2.1.0.
Informe y archivos del estudio
Citar este informe
Shehzad, Asad (2026). Urdu Sukhan ASR: Accurate Urdu Speech Recognition at Half the Size of Whisper large-v3. Loudness.ai, LA-RB-2026-004, versión 1.0. https://loudness.ai/research/urdu-speech-recognition-whisper/ DOI: 10.5281/zenodo.23518703.